
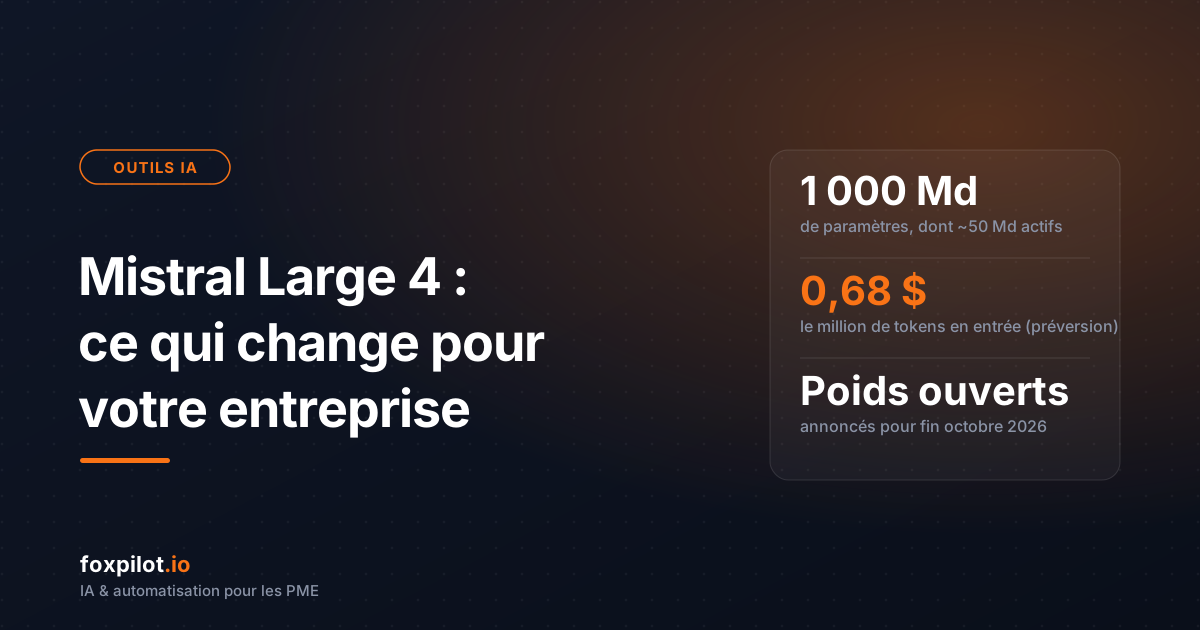
Mistral Large 4 : ce que le nouveau modèle de Mistral change (vraiment) pour votre entreprise
Mistral lance Large 4 : plus de 1 000 milliards de paramètres, un prix bien sous Claude et GPT-6, des poids ouverts fin octobre. Benchmarks décodés.
En résumé : Mistral AI a ouvert le 6 octobre 2026 la préversion de Mistral Large 4, son plus gros modèle : 1 050 milliards de paramètres, dont une cinquantaine de milliards actifs pour chaque mot produit, capable de lire texte et images et de traiter jusqu’à un million de tokens de contexte. Il est facturé aujourd’hui 0,68 dollar par million de tokens en entrée et 2,09 dollars en sortie — moitié moins que le prix annoncé, et de six à dix fois moins que Claude Opus 5.5. Ses poids, c’est-à-dire le modèle lui-même, seront publiés fin octobre : on pourra l’installer chez soi. Mistral le dit très fort en cybersécurité et en analyse d’images ; la mesure indépendante d’Artificial Analysis le place nettement derrière les meilleurs modèles américains en intelligence générale. Pour une entreprise française, ce n’est pas un remplaçant de ChatGPT ou de Claude : c’est la première option européenne de très haut niveau, bon marché et installable sur ses propres serveurs.
Déclaration d’intérêt. Foxpilot conseille des entreprises dans le choix et le déploiement de modèles d’IA, y compris pour décider de ne pas en changer. Cet article n’est sponsorisé par aucun éditeur. Chaque chiffre est daté et sourcé, pour que vous puissiez vérifier sans nous croire sur parole.
Mistral appelle officieusement son modèle ML4 et, « très officiellement », le Chonk — l’argot d’Internet pour un chat bien en chair, que la documentation illustre d’ailleurs d’un chat en pixels. Le surnom dit l’essentiel : c’est le modèle le plus massif jamais publié par l’entreprise. La question pour un dirigeant ou une DSI n’est pas de savoir s’il est gros, mais s’il change un choix qu’ils ont déjà fait.
Mistral Large 4, c’est quoi exactement ?
Un modèle de langage est un programme qui prédit, mot après mot, la suite la plus probable d’un texte. Ses paramètres sont les réglages internes appris pendant l’entraînement : plus il y en a, plus le modèle peut retenir de nuances. Mistral Large 4 en compte 1 050 milliards, contre 675 milliards pour Mistral Large 3, sorti en décembre 2025.
Il ne les utilise pas tous à la fois. Large 4 est un mélange d’experts (Mixture of Experts) : imaginez un cabinet de mille spécialistes où, pour chaque mot à écrire, un aiguilleur ne consulte que les plus compétents sur la question. Ici, une cinquantaine de milliards travaillent à chaque étape : 49 selon l’annonce, 52 selon la fiche technique, corrigée dans la journée du 6 octobre. Le modèle garde la culture d’un géant, mais coûte à faire tourner comme un modèle bien plus petit — c’est ce qui permet son prix.
Trois autres caractéristiques comptent pour une entreprise :
- Il lit les images autant que le texte : schémas techniques, graphiques, documents scannés, photos.
- Il raisonne ou répond directement, selon la difficulté : Mistral le décrit comme un modèle « hybride », qui réunit en un seul modèle réponse rapide, raisonnement et usage d’outils.
- Il accepte un million de tokens de contexte selon sa fiche technique. Un token est un morceau de mot : un million de tokens, c’est l’équivalent de plusieurs livres envoyés en une seule requête. Artificial Analysis relève de son côté 524 000 tokens sur la préversion.
Mistral précise enfin que le modèle a été entraîné « from scratch » sur 3 800 processeurs graphiques NVIDIA Grace Blackwell, dans ses propres centres de données européens, et sur des données couvrant plus de 160 langues, dont toutes les langues officielles de l’Union.
Combien coûte Mistral Large 4, et face à ChatGPT et Claude ?
Les modèles d’IA se facturent au million de tokens, en distinguant ce que vous envoyez (l’entrée) de ce que le modèle produit (la sortie). L’annonce de Mistral affiche 1,36 dollar en entrée et 4,18 dollars en sortie. Mais le 6 octobre 2026, la documentation officielle barre ces deux montants et applique 0,68 et 2,09 dollars, sans dire combien de temps durera cette remise. Le traitement par lots, pour les gros volumes non urgents, divise encore la facture par deux.
| Modèle (tarif API standard) | Éditeur | Entrée, par million de tokens | Sortie, par million de tokens | Poids publiés |
|---|---|---|---|---|
| Mistral Large 4 (préversion) | Mistral AI, France | 0,68 $ (1,36 $ annoncé) | 2,09 $ (4,18 $ annoncé) | Annoncés fin octobre 2026 |
| Mistral Large 3 | Mistral AI, France | 0,50 $ | 1,50 $ | Oui, Apache 2.0 |
| Claude Sonnet 5.5 | Anthropic, États-Unis | 2 $ | 10 $ | Non |
| Claude Opus 5.5 | Anthropic, États-Unis | 4 $ | 20 $ | Non |
| GPT-6.1 Sol | OpenAI, États-Unis | 2 $ | 10 $ | Non |
| GPT-6 Astra (contexte court) | OpenAI, États-Unis | 10 $ | 50 $ | Non |
Prix relevés le 6 octobre 2026 sur les pages officielles de chaque éditeur, hors remises négociées.
Concrètement : une PME qui fait résumer chaque mois 2 000 documents de 10 pages — en comptant large 1 000 tokens par page et 500 tokens par résumé — envoie 20 millions de tokens et en reçoit un million. Avec Mistral Large 4 au tarif du jour, la facture est d’environ 16 dollars par mois ; 31 dollars au prix annoncé. La même tâche coûte environ 100 dollars avec Claude Opus 5.5 et 250 dollars avec GPT-6 Astra.
Deux réserves. D’abord, ce calcul est un ordre de grandeur : chaque éditeur découpe le texte en tokens à sa façon, et Artificial Analysis juge Large 4 « très verbeux » — il produit beaucoup de texte quand il raisonne, ce qui gonfle la sortie. Ensuite, à cette échelle, la facture du modèle reste faible devant le coût d’intégration et de supervision : l’écart de prix devient décisif sur les gros volumes, pas sur un pilote.
Que valent ses benchmarks, en clair ?
Un benchmark est un examen standardisé : la même série d’exercices posée à plusieurs modèles, pour les comparer. Voici les principaux résultats publiés par Mistral, traduits en langage courant.
| Test | Ce qu’il mesure | Résultat de Large 4 annoncé par Mistral |
|---|---|---|
| AA Cyber Index, épreuve « reproduire puis corriger une faille » | Prouver qu’une vraie faille de sécurité existe dans un logiciel open source, puis la corriger | 82 %, le meilleur score de tous les modèles testés |
| Cybench | 40 épreuves tirées de compétitions de cybersécurité | 93 % |
| DeepSWE v1.1 | Mener à bien des tâches réelles de développement logiciel | 61,7 % |
| Terminal-Bench 4.0 | Enchaîner des opérations complexes en ligne de commande | 28,3 % |
| Évaluation humaine à l’aveugle (Surge AI) | Des développeurs notent de 1 à 5 du code dont ils ignorent l’auteur | 3,74 sur 5 : 2ᵉ sur 5 modèles, derrière Claude Opus 5 (4,22) |
| AutomationBench | 657 processus métier dans Gmail, Google Sheets, Slack ou Salesforce | 59,9 % |
| Dense 200 | Repérer précisément des objets dans des images très chargées | 42 %, contre 41 % pour GPT-6 Astra |
| B3 (Lakera) | Résister aux instructions malveillantes cachées dans un document ou une page web | 93,3 % des attaques repoussées |
| Finance Agent v2 et droit (vals.ai) | Tâches de finance et de droit évaluées par un tiers | Au-dessus de GPT-6 Astra, sans score détaillé |
Ces chiffres viennent de l’annonce de Mistral, qui s’appuie pour certains sur des évaluateurs tiers (Artificial Analysis, vals.ai, Surge AI, Lakera). Ils comparent surtout Large 4 à d’autres modèles ouverts : DeepSeek V4 Pro, Kimi K3, Qwen3.8 Max, GLM-5.3. Mistral revendique la première place parmi les modèles ouverts développés aux États-Unis ou en Europe, et une performance « compétitive » avec les meilleurs modèles ouverts mondiaux, chinois compris.
La mesure indépendante raconte une histoire plus nuancée. Sur l’indice d’intelligence d’Artificial Analysis, qui agrège dix évaluations, la préversion obtient 38, 64ᵉ sur 225 modèles — au-dessus de la médiane des modèles de prix comparable (26), mais loin de Claude Opus 5.5 (58) et de GPT-6 Astra (53), mesurés en raisonnement maximal, et derrière le modèle ouvert chinois GLM-5.3 (45). Mistral prévient que son entraînement se poursuit et promet des progrès « rapides » d’ici la publication des poids : les scores d’aujourd’hui sont ceux d’une préversion.
Son vrai point fort : la cybersécurité
C’est la surprise de l’annonce. Sur l’épreuve d’Artificial Analysis qui consiste à reproduire une vraie faille puis à la corriger, Large 4 obtient le meilleur score mesuré, quand Claude Opus 5.5 et GPT-6 Astra sont « proches de zéro » : ils refusent la tâche. Leurs filtres de sécurité bloquent la démonstration d’une faille, alors que c’est souvent la première étape pour la corriger.
Mistral en tire un argument de souveraineté : une équipe de sécurité qui perd l’accès à son outil en pleine crise, ou qui se heurte à un refus, court elle-même un risque. Avec des poids ouverts, elle peut faire tourner le modèle sur ses propres serveurs, sous ses propres règles. Mistral affirme aussi que Large 4 refuse plus souvent que les autres modèles ouverts les demandes manifestement malveillantes. Pour un centre opérationnel de sécurité, un éditeur de logiciels ou un OIV, c’est l’argument le plus concret de l’annonce.
Poids ouverts, open source, gratuit : ce que ça veut dire pour vous
« Poids ouverts » (open weights) signifie que Mistral publiera le fichier du modèle entraîné : n’importe qui pourra le télécharger et le faire tourner sur ses machines, sans passer par l’API de Mistral. Ce n’est pas tout à fait de l’open source : les données et le code d’entraînement ne sont pas publiés, et tout dépend de la licence, encore marquée « Coming soon » dans la documentation. Mistral Large 3 est sous Apache 2.0, la licence la plus permissive ; Mistral Medium 3.5 sous une licence MIT modifiée. La licence de Large 4 dira si l’usage commercial est libre.
Ouvert ne veut pas dire gratuit. Faire tourner 1 050 milliards de paramètres demande de la mémoire graphique : en précision 8 bits, un octet par paramètre, il faut de l’ordre d’un téraoctet pour charger le modèle, environ deux téraoctets en 16 bits, et encore plus de 500 gigaoctets en 4 bits, avant la mémoire nécessaire au contexte. C’est un calcul arithmétique, pas une spécification de Mistral, mais il fixe l’échelle : un serveur à plusieurs processeurs graphiques haut de gamme, pas une machine de bureau. Pour une PME qui veut garder ses données chez elle, Mistral Small 4, neuf fois plus petit (119 milliards de paramètres, dont 6,5 milliards actifs) et sous Apache 2.0, est un point de départ plus réaliste — qui demande tout de même un serveur dédié.
Souveraineté et RGPD : ce qu’apporte un modèle européen
Mistral annonce un déploiement européen qu’il opère de bout en bout, « indépendamment des autres fournisseurs de services numériques et sous droit européen ». Pour une entreprise française, c’est l’argument qui compte face aux éditeurs américains : moins de questions sur les transferts de données hors de l’Union et sur l’exposition aux lois extraterritoriales.
Ce n’est pas une conformité automatique. Un modèle n’est ni conforme ni non conforme au RGPD : c’est l’usage qui l’est. Avant de brancher Large 4 sur vos données, il faut toujours signer l’accord de traitement des données de Mistral, inscrire l’usage au registre, décider ce qui peut être envoyé au modèle et en informer votre DPO — la démarche décrite dans notre guide sur l’IA générative et le RGPD. Côté AI Act, les obligations propres aux modèles d’IA à usage général pèsent sur Mistral, le fournisseur ; votre entreprise, en tant qu’utilisatrice, relève des règles de gouvernance et de conformité des déployeurs — à commencer par l’obligation de maîtrise de l’IA de vos équipes.
Mistral Large 4, ChatGPT ou Claude : lequel pour quel usage ?
| Votre besoin | Notre lecture au 6 octobre 2026 |
|---|---|
| Données sensibles qui ne doivent pas quitter vos serveurs | Large 4 une fois les poids publiés, si vous avez l’infrastructure ; sinon un modèle ouvert plus petit |
| Analyse de vulnérabilités, centre de sécurité | Large 4 : meilleur score mesuré, et pas de refus de principe sur la recherche de failles |
| Documents avec schémas, plans, graphiques ou scans | Large 4 mérite un test : c’est son autre point fort revendiqué |
| Gros volumes d’extraction, de tri ou de résumé | Large 4 ou un modèle plus petit : le prix au token devient décisif |
| Développement logiciel avec un agent de code | Les meilleurs modèles fermés gardent l’avantage, selon l’évaluation à l’aveugle publiée par Mistral lui-même |
| Bureautique au quotidien (e-mails, comptes rendus) | Le choix du modèle compte moins que l’outil déjà intégré à votre suite : voir quelle IA choisir pour votre entreprise |
La bonne pratique n’a pas changé : plutôt que de miser sur un seul modèle, concevoir vos applications pour pouvoir en changer. Un assistant RAG sur vos documents ou un agent IA intégré à votre SI bien architecturés permettent de tester Large 4 sur un cas réel sans tout reconstruire.
Comment tester Mistral Large 4 dès aujourd’hui
- Créer un compte sur Mistral Studio, la console développeur de Mistral, et générer une clé d’API : le modèle s’appelle
mistral-large-4. - Le tester dans le bac à sable (playground) de la console avant d’écrire une ligne de code.
- Comparer sur vos propres exemples, pas sur les benchmarks : vingt cas réels de votre métier, notés à l’aveugle par ceux qui font le travail, valent mieux que n’importe quel classement.
- Ne pas envoyer de données personnelles ou confidentielles pendant l’essai, tant que l’accord de traitement et le registre ne sont pas en place.
L’annonce ne mentionne que l’API : rien n’indique à ce stade l’arrivée du modèle dans l’assistant grand public de Mistral.
Ce qu’on ne sait pas encore
- La licence des poids, marquée « Coming soon » : elle dira si l’usage commercial est libre.
- La date exacte de publication des poids : « d’ici la fin du mois », selon Mistral.
- La durée de la remise : la documentation applique la moitié du prix annoncé, sans échéance.
- Les scores du modèle final : Mistral annonce de nouveaux benchmarks, l’architecture détaillée et sa méthode d’entraînement à la publication des poids.
- Sa disponibilité chez les grands clouds (AWS, Azure, Google Cloud) : non annoncée.
Le verdict Foxpilot
Mistral Large 4 ne détrône pas Claude ou GPT-6 en intelligence générale, et Mistral ne le prétend pas. Il fait mieux que cela pour un acheteur européen : il rend crédible, à un prix six à dix fois inférieur, une option de très haut niveau que l’on pourra faire tourner chez soi. Trois conseils, quelle que soit votre taille : ne rien migrer sur la foi d’une préversion ; tester sur vos cas réels pendant que le prix est divisé par deux ; et attendre la licence des poids avant tout projet d’hébergement interne. Si vos équipes de sécurité ou vos données sensibles vous ont tenu à l’écart de l’IA générative, c’est le moment de rouvrir le dossier.
Comment Foxpilot vous accompagne
- Comparer les modèles sur vos cas d’usage — un banc d’essai à l’aveugle sur vos documents, avec un AI Engineer qui mesure qualité, coût et latence.
- Concevoir des applications indépendantes du modèle — RAG et agents IA capables de passer de Claude à Mistral sans réécriture.
- Cadrer la conformité — registre, accord de traitement, gouvernance AI Act avant tout envoi de données.
- Former vos équipes à choisir le bon modèle pour la bonne tâche.
Le point de départ reste un diagnostic IA gratuit de trente minutes.
Sources
- Introducing Mistral Large 4 (nouvel onglet) — Mistral AI
- Mistral Large 4 — fiche du modèle (nouvel onglet) — Mistral AI
- Pricing — Mistral Docs (nouvel onglet) — Mistral AI
- Mistral Large 3 — fiche du modèle (nouvel onglet) — Mistral AI
- Mistral Large 4 Preview — Intelligence, Performance & Price Analysis (nouvel onglet) — Artificial Analysis
- LLM Leaderboard — Intelligence Index (nouvel onglet) — Artificial Analysis
- Pricing — Claude API (nouvel onglet) — Anthropic
- Pricing — OpenAI API (nouvel onglet) — OpenAI
Questions fréquentes
Qu'est-ce que Mistral Large 4 ?
Combien coûte Mistral Large 4 ?
Mistral Large 4 est-il open source et gratuit ?
Quelle est la différence entre Mistral et Claude ?
Mistral Large 4 est-il meilleur que ChatGPT ?
Quelle est la dernière version de Mistral ?
Peut-on installer Mistral Large 4 sur ses propres serveurs ?
Mistral Large 4 est-il conforme au RGPD ?
Vous souhaitez passer à l'action ?
Réservez un échange gratuit de 30 min pour discuter de votre projet IA.
Articles liés
Copilot passe à la facturation à l'usage : ce que les crédits vont coûter à votre entreprise
Depuis le 25 septembre 2026, Cowork, Code et Autopilot se paient en crédits Copilot. Prix, plafond par défaut, calendrier France, RGPD : le point.

Claude Sonnet 5 : le modèle agentique qui rend l'automatisation IA abordable
Anthropic a lancé Claude Sonnet 5 fin juin 2026 : son modèle le plus agentique, proche d'Opus 4.8 pour un coût réduit. Ce que ça change pour PME et ETI.
Publicité dans ChatGPT : ce qui change vraiment pour les entreprises françaises
Depuis le 24 août 2026, ChatGPT affiche des publicités en France sur les forfaits Free et Go. Format, ciblage, pièges : le point pour les marques.